infraestructura cloud nativa: cómo diseñarla sin disparar costes ni complejidad
La infraestructura cloud nativa permite crear y operar sistemas aprovechando capacidades propias de la nube, como el aprovisionamiento automatizado, los servicios gestionados y la escalabilidad bajo demanda. Pero adoptar contenedores o Kubernetes no convierte por sí solo una plataforma en cloud nativa. El cambio real consiste en diseñar aplicaciones, operaciones y controles para que funcionen de forma fiable en un entorno distribuido.
Para una empresa, la decisión no debería partir de una lista de herramientas, sino de una necesidad concreta: reducir el tiempo de despliegue, absorber picos de actividad, mejorar la recuperación ante fallos o simplificar la operación. Una arquitectura bien planteada puede facilitar esos objetivos; una implantación apresurada puede añadir capas de trabajo, costes difíciles de prever y dependencias que el equipo no está preparado para mantener.
El cambio no empieza con Kubernetes, sino con el problema que se quiere resolver
Una infraestructura cloud nativa combina prácticas de desarrollo y operación con servicios y patrones de arquitectura diseñados para entornos de nube. Suele apoyarse en automatización, infraestructura como código, observabilidad, integración continua y despliegue frecuente. Los contenedores son habituales, pero no imprescindibles en todos los casos; tampoco lo son los microservicios.
La distinción importa. Una aplicación monolítica bien estructurada puede ejecutarse en una plataforma cloud nativa y beneficiarse de despliegues automatizados, escalado y servicios gestionados. Dividirla en decenas de microservicios sin una necesidad funcional clara, en cambio, multiplica las comunicaciones de red, la gestión de datos y los puntos de fallo.
Antes de escoger arquitectura, conviene precisar qué limitación se intenta corregir. Si el problema es que cada lanzamiento depende de operaciones manuales, puede bastar con automatizar la canalización de despliegue. Si una campaña concentra el tráfico en pocas horas, el escalado automático puede aportar valor. Si una caída afecta a toda la aplicación, quizá haya que revisar los límites entre componentes y las estrategias de recuperación.
Los componentes que sostienen una plataforma cloud nativa
La infraestructura no es solo una cuenta en un proveedor de nube. Es el conjunto de recursos, políticas y procesos que permite ejecutar aplicaciones de manera repetible. Estos elementos suelen trabajar juntos:
- Infraestructura como código: define redes, permisos, bases de datos y otros recursos mediante archivos versionados. Así se reducen las diferencias entre entornos y se puede revisar un cambio antes de aplicarlo.
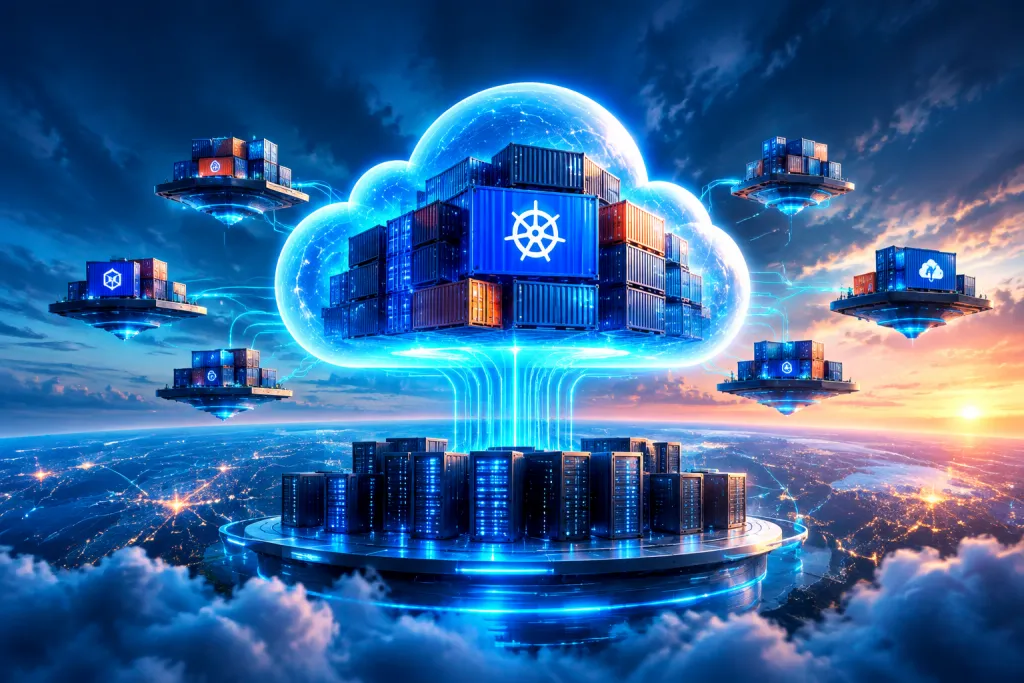
- Contenedores y plataforma de ejecución: empaquetan una aplicación y sus dependencias. Un orquestador como Kubernetes puede coordinar cargas complejas, aunque añade tareas de configuración, actualización y seguridad.
- Servicios gestionados: bases de datos, colas, almacenamiento u otras capacidades operadas parcialmente por el proveedor. Pueden reducir trabajo rutinario, pero hay que revisar disponibilidad, límites, costes y posibilidades de salida.
- Automatización de entrega: integra pruebas, análisis y despliegues. Una canalización fiable detecta errores antes de producción y hace que una versión pueda recuperarse con rapidez.
- Observabilidad: reúne métricas, registros y trazas para entender el comportamiento de un sistema. No se limita a generar alertas: debe ayudar a localizar por qué una petición falla o tarda más de lo esperado.
- Gestión de identidad y secretos: controla quién puede acceder a cada recurso y cómo se almacenan credenciales. Los permisos amplios y las claves incrustadas en el código crean riesgos evitables.
La integración entre estos componentes es más valiosa que la cantidad de tecnología desplegada. Por ejemplo, una plantilla de infraestructura reutilizable, vinculada a permisos mínimos y a una canalización con pruebas, aporta una base coherente para cada nuevo servicio.
Cómo elegir una arquitectura acorde con el tamaño del problema
La decisión entre una aplicación única, servicios modulares o microservicios debe considerar el dominio del negocio, el ritmo de cambios y la capacidad operativa. Los microservicios pueden ser razonables cuando equipos distintos necesitan desplegar componentes de forma independiente o cuando existen requisitos diferentes de escalado. No son una solución automática para acelerar cualquier proyecto.
Un comercio electrónico mediano, por ejemplo, puede empezar con una aplicación modular que concentre catálogo, pedidos y administración en una sola unidad desplegable. Si las campañas generan picos en la búsqueda de productos, ese componente podría separarse más adelante para escalar de forma independiente. La separación se justificaría por una carga observada y una necesidad concreta, no por una preferencia estética.
También hay que decidir cuánto gestionar internamente. Una plataforma Kubernetes autogestionada ofrece control, pero obliga a mantener el plano de control, actualizar nodos, probar políticas y resolver incidencias de clúster. Un servicio gestionado reduce parte de esa carga, aunque conserva responsabilidades sobre las aplicaciones, los permisos, los datos y la configuración. Para equipos pequeños, un servicio de contenedores más sencillo o funciones gestionadas pueden ser una opción más sensata.
Una ruta de adopción que limita el riesgo
La transformación puede avanzar por etapas, con resultados verificables en cada una. No es necesario migrar todo el centro de datos ni reescribir cada aplicación para obtener mejoras operativas.
- Inventariar aplicaciones y dependencias. Identificar propietarios, flujos de datos, requisitos de disponibilidad, integraciones y ventanas de mantenimiento. Este mapa permite distinguir sistemas fáciles de mover de aquellos que requieren rediseño.
- Definir objetivos medibles. Por ejemplo, reducir el tiempo de recuperación, acortar el ciclo de publicación o evitar aprovisionamientos manuales. Los indicadores deben corresponder a problemas reales, no a métricas de moda.
- Seleccionar un caso piloto acotado. Elegir una aplicación con impacto controlado y un equipo dispuesto a participar. Conviene que el piloto pruebe automatización, monitorización y seguridad, no solo que la aplicación arranque en un contenedor.
- Crear una base común. Preparar cuentas o proyectos, redes, políticas de identidad, registro de imágenes, gestión de secretos y módulos de infraestructura como código. Las reglas compartidas reducen decisiones repetidas y errores entre equipos.
- Ensayar fallos y recuperación. Simular la caída de una instancia, una dependencia lenta o un despliegue defectuoso. Verificar que existen alertas útiles, procedimientos claros y una forma probada de volver a una versión estable.
- Ampliar con criterios de salida. Medir el coste de operación, la frecuencia de incidencias y el esfuerzo de los equipos. Si el piloto no mejora la situación, ajustar el diseño antes de replicarlo.
Esta ruta también evita una migración de “todo o nada”. Algunas cargas pueden permanecer en servidores propios por requisitos regulatorios, latencia o dependencia de hardware. La arquitectura híbrida puede ser válida si hay conectividad, identidad y operación bien resueltas; mantener dos entornos sin una estrategia común suele producir duplicidad y puntos ciegos.
Costes, seguridad y operación: decisiones que suelen llegar tarde
El coste cloud no se limita a las máquinas virtuales. También influyen el almacenamiento, las copias, el tráfico de salida, los registros, las licencias y los servicios administrados. Una plataforma con numerosos clústeres pequeños puede resultar más cara que una alternativa más sencilla, sobre todo si hay recursos sobredimensionados o entornos de prueba que nunca se apagan.
Para mantener el gasto bajo control, es útil asignar etiquetas de coste desde el aprovisionamiento, establecer presupuestos por equipo y revisar el consumo junto con métricas de uso. El escalado automático tampoco garantiza ahorro: si las solicitudes de recursos están mal configuradas, el sistema puede reservar capacidad excesiva o reaccionar tarde ante la demanda.
En seguridad, el modelo de responsabilidad compartida exige distinguir qué protege el proveedor y qué debe configurar la empresa. La plataforma puede ofrecer cifrado y controles de identidad, pero una política permisiva, una imagen vulnerable o un secreto expuesto siguen siendo problemas del equipo que despliega la aplicación. Las medidas prácticas incluyen permisos mínimos, análisis de imágenes, actualización planificada de dependencias y separación entre entornos.
La operación necesita responsables y procedimientos, no solo paneles de control. Cada servicio debe tener un propietario, objetivos de disponibilidad proporcionados a su criticidad y una guía para responder a incidentes. Si nadie sabe quién debe actuar cuando una base de datos gestionada se degrada, la adopción de servicios cloud no habrá resuelto el problema operativo.
Señales de que la estrategia necesita ajustes
Hay indicios de que la arquitectura está añadiendo más complejidad de la que elimina: los despliegues dependen de cambios manuales, los equipos no pueden explicar el coste de sus servicios, una alerta genera ruido sin indicar una acción, o un cambio menor obliga a coordinar muchas dependencias. También es una señal de alerta que solo una persona conozca el clúster o que las aplicaciones no tengan un procedimiento de recuperación probado.
En esos casos, la respuesta no siempre es incorporar otra herramienta. Puede ser reducir componentes, estandarizar plantillas, mejorar la documentación operativa o devolver a una aplicación una estructura más simple. Una plataforma útil ofrece caminos recomendados que permiten desplegar con autonomía dentro de límites seguros; no obliga a cada equipo a convertirse en especialista de infraestructura.
La infraestructura cloud nativa tiene sentido cuando responde a necesidades verificables y existe capacidad para operar sus componentes con disciplina. El siguiente paso práctico es elegir una aplicación piloto, medir su situación actual y acordar qué mejora justificaría ampliar el modelo. Esa evidencia permite decidir si conviene escalar la plataforma, simplificarla o mantener una solución más tradicional donde resulte adecuada.