La IA de Microsoft alcanza un 83 % de acierto en una prueba de diagnósticos complejos
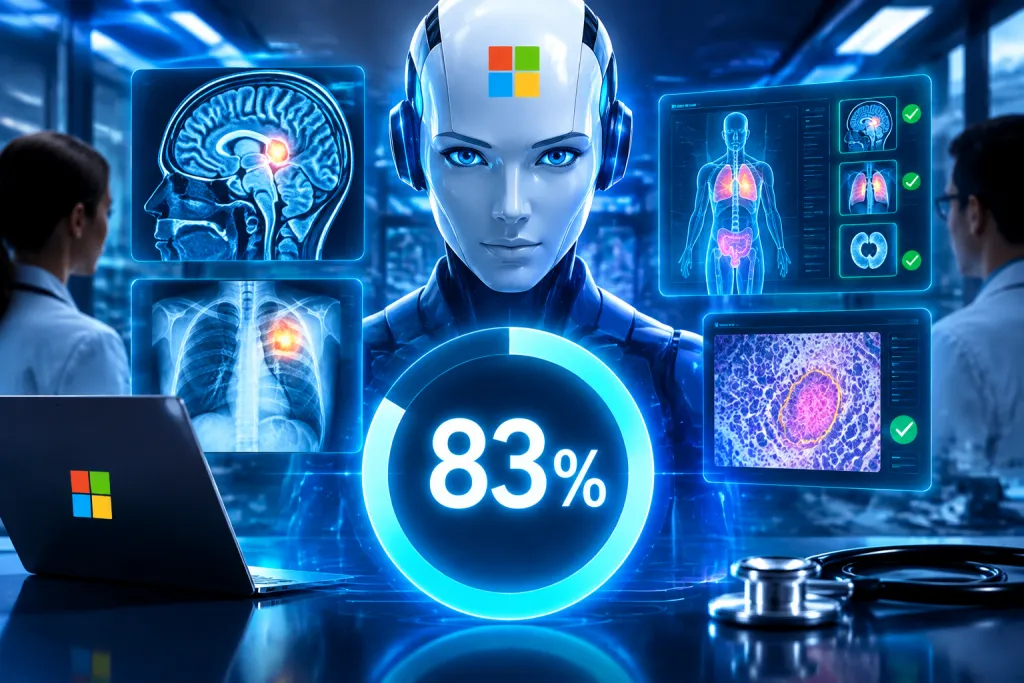
Una inteligencia artificial de Microsoft alcanzó un 83 % de acierto en una prueba centrada en diagnósticos médicos complejos. El resultado muestra la capacidad de estos sistemas para analizar información clínica y proponer posibles explicaciones para síntomas difíciles de interpretar. Sin embargo, una puntuación en una evaluación no equivale a demostrar que la herramienta pueda diagnosticar pacientes sin supervisión: el contexto, la calidad de los datos y la revisión de profesionales siguen siendo determinantes.
Qué indica el 83 % de acierto
La cifra resume el rendimiento del sistema en una prueba concreta. En términos sencillos, significa que la inteligencia artificial llegó a una respuesta considerada correcta en una parte significativa de los casos evaluados. Pero ese porcentaje debe leerse junto con las condiciones del examen: qué información se entregó, qué se consideró una respuesta válida y qué tipo de problemas se plantearon.
La expresión diagnósticos complejos suele aludir a situaciones en las que los síntomas pueden corresponder a distintas enfermedades o en las que hace falta combinar antecedentes, resultados de pruebas y evolución clínica. En estos escenarios, el reto no consiste solo en reconocer una señal aislada. También hay que valorar hipótesis alternativas, detectar datos que faltan y ponderar riesgos.
Por eso, el 83 % no debe interpretarse como una tasa de acierto garantizada en consultas reales. Una prueba controlada puede medir capacidades concretas, pero no reproduce toda la variedad de pacientes, centros médicos y circunstancias que intervienen en la atención. Tampoco informa por sí sola de cómo se comportaría la herramienta ante un caso poco frecuente o una historia clínica incompleta.
Por qué los casos difíciles son un reto para la IA
Los sistemas de inteligencia artificial procesan grandes cantidades de texto y pueden relacionar síntomas con patrones aprendidos durante su entrenamiento. Esa habilidad resulta útil cuando un caso contiene muchos detalles y las pistas aparecen dispersas en diferentes partes de la información. La herramienta puede ordenar esos elementos, resumirlos y sugerir opciones que merecen una revisión más detenida.
El razonamiento médico, sin embargo, no se reduce a encontrar coincidencias. Un síntoma puede tener causas muy distintas y su importancia depende de factores como la edad, los antecedentes, la medicación o el tiempo de evolución. Además, una respuesta plausible no siempre es la más segura. Un sistema debe evitar tanto pasar por alto una condición grave como recomendar pruebas innecesarias.
También existe una diferencia entre elaborar una lista de posibles diagnósticos y tomar una decisión clínica. La primera tarea puede servir como apoyo para explorar alternativas. La segunda implica considerar el estado de la persona, explicar opciones, asumir responsabilidades y adaptar la atención a sus necesidades. La IA puede contribuir al análisis, pero no sustituye ese conjunto de funciones.
El valor de ordenar la información
Una aplicación razonable de estas herramientas consiste en ayudar a estructurar datos que, de otro modo, podrían resultar difíciles de revisar con rapidez. Un modelo puede resumir antecedentes, señalar contradicciones o destacar que una hipótesis no encaja con ciertos síntomas. Ese apoyo puede orientar la conversación entre profesionales y facilitar una segunda revisión.
La utilidad depende de que el resumen sea fiel al expediente y de que las propuestas se puedan comprobar. Si el sistema omite un antecedente importante o presenta una conclusión incierta con excesiva seguridad, el resultado puede inducir a error. Por eso, la revisión humana no es un añadido opcional, sino una salvaguarda central.
De una evaluación a la práctica clínica
Para trasladar un resultado de laboratorio a un entorno asistencial hacen falta más pruebas. Un modelo debe evaluarse con información representativa de la población a la que pretende atender y en situaciones que reflejen el trabajo cotidiano. También conviene comprobar si conserva un rendimiento adecuado ante distintas formas de redactar los síntomas o ante expedientes con datos ausentes.
La evaluación debe observar algo más que la respuesta final. Importa saber si el sistema identifica señales de alarma, si comunica su incertidumbre y si distingue entre una sugerencia orientativa y una indicación médica. Un buen resultado promedio puede ocultar fallos en grupos concretos o en enfermedades menos habituales. En salud, esos fallos pueden tener consecuencias relevantes.
Antes de utilizar una herramienta en una organización sanitaria, también hay que definir quién revisa sus recomendaciones, cómo se documenta su intervención y qué ocurre cuando discrepa del criterio profesional. La integración con los sistemas clínicos debe respetar la privacidad y limitar el acceso a la información. La tecnología tiene que encajar en procesos claros, no añadir una capa de opacidad.
El papel de Microsoft y la competencia tecnológica
El resultado sitúa a Microsoft dentro de una competencia amplia por aplicar modelos de inteligencia artificial a tareas especializadas. La medicina concentra interés porque combina abundante información textual con problemas de gran complejidad. A la vez, es un ámbito especialmente exigente: un error puede afectar a decisiones que tienen impacto directo en la salud.
Para las empresas tecnológicas, demostrar capacidad en una prueba es solo una parte del desafío. También deben ofrecer sistemas fiables, proteger los datos y explicar cómo se generan las recomendaciones. En el sector sanitario, la confianza no depende únicamente de la sofisticación del modelo. Requiere controles, trazabilidad y una evaluación independiente que permita entender sus límites.
La colaboración con profesionales puede ayudar a detectar errores que no son evidentes en una evaluación automática. Los médicos conocen las consecuencias de una omisión, las particularidades de cada especialidad y la forma en que se toman decisiones bajo incertidumbre. Su participación permite valorar si una herramienta resulta útil dentro de un flujo de trabajo real, en lugar de limitarse a medir su desempeño en una tarea aislada.
Precisión, explicaciones y responsabilidad
Un porcentaje de acierto no responde a todas las preguntas que plantea el uso de IA médica. También interesa conocer cuántas respuestas incorrectas pueden ser peligrosas, qué tipos de error se repiten y si el sistema ofrece razones comprensibles para sus propuestas. La precisión general puede ser alta y, aun así, no bastar para una función clínica concreta.
La responsabilidad debe quedar definida antes de incorporar estos sistemas. Si una recomendación automatizada influye en una decisión, los profesionales y las instituciones necesitan criterios para verificarla y corregirla. El fabricante, por su parte, debe comunicar las condiciones de uso y las limitaciones conocidas. Sin esa claridad, resulta difícil establecer cuándo confiar en la herramienta y cuándo descartarla.
Una promesa que necesita comprobación
La cifra del 83 % refleja un avance en la capacidad de una IA para abordar preguntas médicas complejas, pero no constituye una autorización para reemplazar consultas ni para tomar decisiones autónomas. Su significado depende del diseño de la prueba y de la distancia que exista entre ese ejercicio y la atención a personas con necesidades diversas.
El escenario más realista es el de una herramienta de apoyo sometida a supervisión. Puede ayudar a organizar información, proponer hipótesis y llamar la atención sobre aspectos que conviene revisar. La decisión final requiere integrar esos aportes con la exploración, el criterio profesional y las preferencias del paciente.
El potencial de la inteligencia artificial en medicina no se medirá solo por su capacidad para acertar una respuesta. También dependerá de su seguridad, de la calidad de sus explicaciones y de su integración responsable en los servicios sanitarios. El resultado de Microsoft aporta una señal de capacidad, mientras que la validación clínica y la supervisión humana siguen siendo indispensables para convertir esa capacidad en una herramienta fiable.