Opera presenta WebAI para ejecutar modelos de inteligencia artificial en el navegador sin depender de la nube
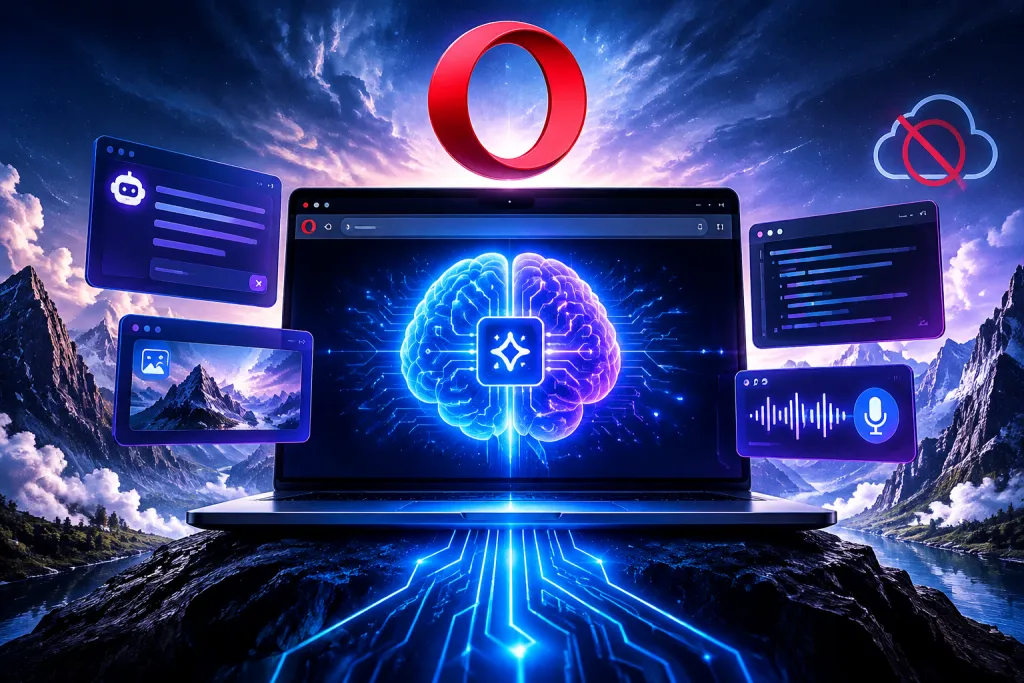
Opera presenta WebAI, una iniciativa para ejecutar modelos de inteligencia artificial directamente en el navegador, sin que cada tarea tenga que enviarse a un servicio remoto. La propuesta apunta a una forma distinta de integrar estas herramientas en la navegación: procesar determinadas solicitudes en el dispositivo del usuario y reservar la conexión con la nube para los casos que la requieran. El planteamiento puede influir tanto en la privacidad como en la velocidad, aunque su alcance dependerá de los modelos disponibles, del equipo y de las funciones que se incorporen.
Qué propone WebAI para la navegación
La mayoría de los servicios de inteligencia artificial accesibles desde una página web funcionan mediante una arquitectura distribuida. El usuario escribe una instrucción, el navegador la envía a servidores externos y allí se realiza el procesamiento. La respuesta vuelve después al dispositivo. Este esquema permite utilizar modelos grandes sin exigir una capacidad de cálculo elevada en el ordenador o el teléfono, pero también necesita conexión y supone que parte de la información salga del entorno local.
WebAI plantea trasladar una parte de ese trabajo al navegador. En lugar de depender por defecto de un centro de datos remoto, el modelo podría ejecutarse en el propio dispositivo, utilizando recursos como el procesador y, cuando corresponda, capacidades de aceleración disponibles en el equipo. El navegador actuaría así no solo como una ventana para acceder a aplicaciones, sino también como un espacio desde el que iniciar tareas de inteligencia artificial.
La idea no significa que toda función de IA vaya a operar sin conexión ni que cualquier modelo pueda ejecutarse en cualquier ordenador. El rendimiento depende del tamaño del modelo, de la memoria disponible, de la potencia del hardware y de la forma en que se haya preparado el software. Por eso, la ejecución local se entiende mejor como una alternativa para determinadas operaciones que como un reemplazo universal de los servicios en la nube.
Procesamiento local y privacidad
Uno de los argumentos principales a favor de la inteligencia artificial en el dispositivo es el control de los datos. Si una solicitud se resuelve localmente, el contenido puede permanecer en el ordenador en vez de enviarse a un proveedor externo. Esto resulta pertinente para tareas que incluyen notas personales, documentos de trabajo o información que el usuario prefiere no compartir con un servicio remoto.
Sin embargo, ejecutar un modelo en el navegador no garantiza por sí solo la privacidad. La protección también depende del diseño de cada función, de los permisos solicitados, del almacenamiento de los datos y de las comunicaciones que mantenga la aplicación. Una herramienta podría procesar una parte de la solicitud en local y recurrir a servidores para otra. Para evaluar esa diferencia, será necesario que la interfaz explique con claridad qué información se procesa, dónde se realiza el cálculo y qué datos se conservan.
La transparencia cobra especial importancia cuando la inteligencia artificial se integra en tareas cotidianas. Una indicación visible sobre el modo de ejecución ayudaría a distinguir entre procesamiento local y remoto. También permitiría que cada persona valore el equilibrio entre privacidad, calidad de respuesta y consumo de recursos, en lugar de asumir que todas las operaciones funcionan de la misma manera.
Qué cambia cuando los datos no salen del equipo
El procesamiento local puede reducir la exposición de la información durante una consulta, porque evita transmitirla a un servidor para esa operación concreta. También puede disminuir la dependencia de una conexión estable. Aun así, no elimina los riesgos asociados al uso de una herramienta: una respuesta puede ser inexacta, el modelo puede interpretar mal una instrucción y la aplicación todavía puede gestionar datos mediante otros componentes.
Por esa razón, la privacidad debe entenderse como una propiedad del sistema completo, no como una consecuencia automática de tener un modelo instalado en el dispositivo. La ubicación del cálculo es un elemento relevante, pero no reemplaza las políticas de permisos, la seguridad del navegador ni las decisiones informadas del usuario.
Ventajas y límites de los modelos en el dispositivo
La ejecución local ofrece beneficios prácticos en escenarios donde una respuesta rápida o la continuidad sin conexión son importantes. Al no depender de un viaje de ida y vuelta hasta un servidor, algunas tareas podrían completarse con menor latencia. Además, un uso local puede reducir el volumen de solicitudes que una aplicación envía a infraestructuras externas, aunque el ahorro concreto dependerá de la carga de trabajo y de cómo se haya implementado cada función.
La contrapartida está en los recursos. Los modelos requieren memoria y capacidad de cálculo, y su funcionamiento puede afectar al consumo de energía o al rendimiento de otras aplicaciones. En dispositivos con hardware limitado, una operación local podría ser más lenta que una consulta remota. También puede haber diferencias de calidad entre un modelo compacto ejecutado en el equipo y uno más grande alojado en servidores especializados.
Entre los factores que pueden influir en la experiencia destacan:
- La capacidad del dispositivo: la memoria y el procesador disponibles condicionan qué modelos pueden funcionar y con qué rapidez.
- El tipo de tarea: resumir un texto breve plantea exigencias distintas a analizar documentos extensos o generar contenido complejo.
- La conexión: una función local puede seguir disponible sin acceso a internet, pero otras capacidades pueden requerir servicios remotos.
- La gestión de recursos: el navegador debe equilibrar el trabajo de la IA con el consumo de batería y la actividad de otras pestañas.
- La actualización de los modelos: la calidad y la seguridad dependen de que el software se mantenga y se distribuya de forma adecuada.
Estos límites hacen probable que convivan distintos modos de procesamiento. Una aplicación podría recurrir a un modelo local para acciones sencillas y utilizar un servicio en la nube cuando la petición exija más capacidad. La utilidad de WebAI dependerá, en buena medida, de que esa transición sea comprensible y de que el usuario pueda saber qué opción se está empleando.
El navegador como plataforma para la inteligencia artificial
La propuesta también tiene una dimensión empresarial. Los navegadores compiten por convertirse en el centro desde el que las personas realizan tareas, organizan información y acceden a servicios. Incorporar herramientas de inteligencia artificial puede ampliar ese papel, pero también plantea una decisión estratégica: ofrecer capacidades propias, permitir que otros desarrolladores las aprovechen o combinar ambas vías.
Si una tecnología de ejecución local se integra de forma accesible, los desarrolladores podrían crear funciones asistidas por modelos sin construir desde cero toda la infraestructura de procesamiento. Eso facilitaría probar experiencias que trabajen con texto u otros contenidos dentro del navegador. La facilidad real dependerá de las herramientas de programación, de la compatibilidad entre dispositivos y de las condiciones de acceso que establezca la plataforma.
Para Opera, el reto no consiste únicamente en anunciar una posibilidad técnica. También deberá mostrar cómo se traduce en funciones concretas y qué ventajas ofrece frente a las aplicaciones que ya operan desde servidores. La adopción dependerá de factores cotidianos: que la respuesta sea útil, que el sistema no ralentice la navegación y que la configuración no añada complejidad innecesaria.
Un equilibrio entre nube y dispositivo
El debate sobre la IA local no plantea necesariamente una elección excluyente. La nube aporta capacidad para ejecutar modelos de gran tamaño y centralizar su mantenimiento. El dispositivo ofrece más control sobre determinados datos y puede reducir la dependencia de una conexión para algunas tareas. Una arquitectura híbrida podría combinar ambos enfoques, siempre que explique cuándo se activa cada uno y permita al usuario tomar decisiones.
Ese equilibrio también repercute en los costes. El procesamiento remoto requiere infraestructura y puede implicar límites de uso o modelos de acceso comercial. El procesamiento local aprovecha el hardware del usuario, pero traslada parte del coste al consumo de recursos del equipo y a la necesidad de mantener los modelos. No existe una solución idéntica para todos los usos: la elección más adecuada depende de la complejidad de la tarea y de las expectativas de privacidad y rendimiento.
Qué deberá demostrar la propuesta
La viabilidad de WebAI se medirá por su aplicación práctica. Para que la ejecución local resulte atractiva, debe ser sencilla de activar, funcionar en una variedad razonable de equipos y ofrecer resultados útiles sin exigir conocimientos técnicos. También será necesario explicar qué modelos intervienen, qué recursos consumen y qué ocurre cuando el dispositivo no puede completar una tarea.
La compatibilidad representa otro punto decisivo. El parque de dispositivos es diverso y no todos cuentan con la misma potencia o memoria. Si la experiencia se limita a equipos de altas prestaciones, la función podría quedar fuera del alcance de una parte de los usuarios. Si, por el contrario, los modelos se ajustan a configuraciones modestas, la calidad de las respuestas y el tiempo de espera deberán mantenerse en niveles adecuados.
La confianza dependerá asimismo de los límites de la inteligencia artificial. Un modelo local puede generar errores o presentar como válida una respuesta incorrecta, igual que un sistema remoto. La ubicación del procesamiento no convierte automáticamente la salida en fiable. Por ello, las funciones deberían dejar claro cuándo se utiliza IA y facilitar que el contenido generado pueda revisarse antes de emplearlo en decisiones o comunicaciones relevantes.
Una nueva capa de competencia entre navegadores
La presentación de WebAI sitúa a Opera en una conversación más amplia sobre el lugar de la inteligencia artificial en el software de uso diario. La cuestión ya no se limita a qué asistente ofrece una respuesta más elaborada. También importa dónde se ejecuta el modelo, qué información necesita, cuánto depende de una conexión externa y qué control conserva la persona sobre sus datos.
Si la iniciativa consigue traducirse en herramientas útiles, podría reforzar el papel del navegador como entorno de trabajo y no solo como puerta de entrada a páginas y aplicaciones. Pero la tecnología tendrá que convivir con restricciones de hardware, diferencias de calidad y exigencias de transparencia. La ejecución local aporta una alternativa relevante a la nube, no una solución automática para todos los problemas de la inteligencia artificial.
El interés de WebAI reside precisamente en abrir esa posibilidad dentro del navegador. Su impacto dependerá de cómo Opera convierta la propuesta en experiencias concretas y de si los usuarios perciben ventajas claras en privacidad, rapidez o autonomía. La combinación de procesamiento local y remoto apunta a un modelo más flexible, cuyo valor final se definirá por la utilidad diaria y por la claridad con que se gestionen sus límites.